Cog-WM 1.0:类脑 JEPA 隐空间预测驱动的统一架构具身导航和操作
一、人脑认知地图机制:主动探索具身导航到价值引导具身操作的共享机制
具身导航与操作面临的共同挑战
当前具身导航与操作的主流范式 —— 以大语言模型(LLM)为骨干的端到端视觉语言导航(VLN)、视觉语言动作模型(VLA)—— 基于Transformer架构进行数据和计算的扩展来实现导航与操作任务,虽然架构简单扩展性好,但在物理世界中面临着共同的挑战:
首先是海量数据需求与特定环境适配。当前模型通常需要上万小时的海量数据训练,尽管如此当任务的背景、视角、物体位置或任务组合发生变化时,仍需要重新微调以达到可用程度。
其次是跨任务长期记忆难以复用。机器人有时需要找到几天前见过的一把钥匙;而现有模型目标离开视野不久,机器人就可能失去相关上下文。
第三是长程行动效率低易失败。任务一长,局部动作与最终目标之间的联系就变弱,错误还会逐步累积。
人脑认知地图机制的启示
人类大脑是目前已知的智能程度最高的具身功能机制与计算架构,人脑从功能到结构的神经机制研究既开启了人工智能(Artificial Intelligence,AI)的探索,也在过去的70年里事实上多次启发了人工智能能力的重大突破,更会是推动AI迈向下一个能力突破里程碑的重要路径。人类的具身智能(Embodied Intelligence)能力包括感知、认知、决策、规划、执行以支撑导航、操作、交互、协作等多种任务。其中区分离身智能(Disembodied Intelligence)和具身智能的物理世界执行能力又以导航和操作能力为核心。那么人类大脑是如何驱动人的身体不需要预制建图地进行主动探索语义导航和操作的呢?
人脑驱动身体在开放世界里进行主动探索导航和操作的核心机制是认知地图(cognitive map):认知地图是人脑中对环境中位置、物体、事件及其相互关系与状态转移结构的结构化内部表征,在个体对环境进行持续感知、探索和行动交互的过程中逐步形成,并随新经验不断更新,使得人脑能够记忆、预测并基于此进行规划。认知地图机制涉及多个脑区的功能协作,其中主要包括以前额叶皮层调控为核心的感知与规划模块,以海马-内嗅皮层为核心的结构化记忆与预测模块,两套功能分离却又有机整合的智能系统让感知编码的选择性注意、任务规划与状态预测、认知地图构建与刷新等机制分工协作,从而让人形成”感知 - 记忆 - 预测 - 行动”的主动探索与能力闭环。
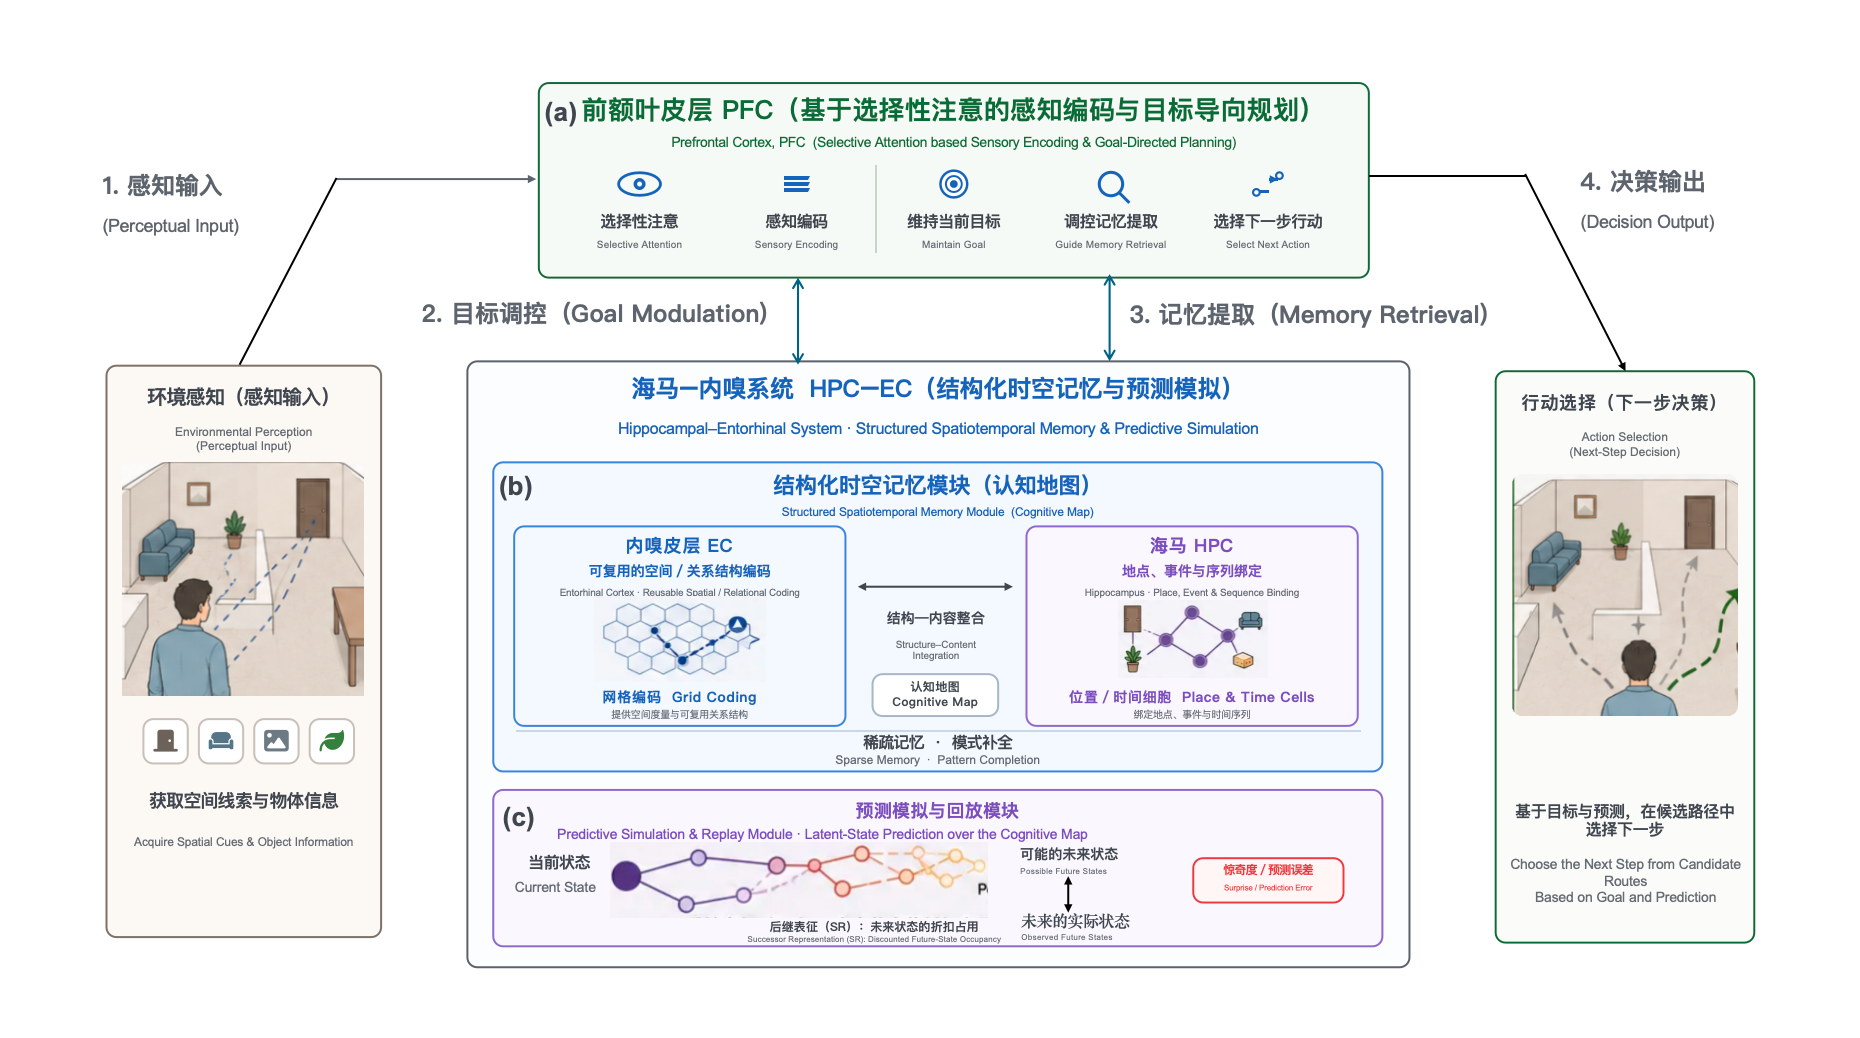
如图1.a,以前额叶皮层调控为核心的感知与规划模块承担连接环境感知、时空记忆与行动决策的目标导向控制功能。面对连续输入的高维感知信息,前额叶皮层将其压缩后根据当前任务目标,通过自上而下的选择性注意调节感知编码,优先表征与当前行为相关的空间线索、物体信息及环境变化,并将其组织为可供后续时空记忆编码与预测性计算使用的任务相关表征。与此同时,前额叶皮层在工作记忆中维持当前目标与任务状态,并通过与海马-内嗅皮层系统的双向交互,调节与当前情境相关的地点、事件及状态转移关系的记忆编码与检索。海马-内嗅皮层系统提供的结构化记忆与未来状态预测进一步与前额叶皮层维持的当前目标和任务约束相结合,用于比较不同候选路径及其可能产生的行动结果,并进而形成下一步行动决策。由此,前额叶皮层通过“选择性编码—目标维持—记忆检索—预测未来—行动选择”的连续控制过程,将感知输入、认知地图与预测结果动态耦合,为复杂环境中的目标导向导航与操作提供计算控制基础。
如图1.b,海马-内嗅皮层中的结构化记忆模块把”空间在哪里(Where)“与”看到了什么(What)“分置于可分离的两套编码通路,网格细胞在内嗅皮层给出一种与内容无关、可跨环境复用的空间度量骨架,位置细胞在其上把具体地点与事件绑定。同时,在前额叶皮层选择性注意和任务目标的调节下,海马记忆呈现出稀疏且有选择的编码特征:有限的神经元群体即可形成对特定地点或事件的区分性表征,并能够基于部分线索通过模式补全恢复相关情境,而非逐帧存储完整的像素级感知输入。这种时空记忆机制与主要依赖网络参数与有限历史上下文保存经验的部分VLN/VLA架构形成鲜明对比。其关键并非简单减少存储的信息量,而是将高维、连续且高度冗余的感知流,转换为可跨环境复用的空间结构和任务相关的稀疏内容表征。由此,后续预测模块可以在结构化的潜在状态空间中学习地点、事件及其状态转移规律,而不必直接从逐帧像素序列中重复提取相同的空间关系,从而降低预测学习的表征维度与样本复杂度,并为跨环境迁移和组合泛化提供机制基础。
如图1.c,海马-内嗅皮层中的多层级预测模块,是将认知地图中存储的代表了人脑在各种环境下学习到的导航与操作经验的状态及其转移关系,通过海马—内嗅系统与前额叶皮层的双向交互,转化为对候选未来和行动结果的多层级预测。后继表征(successor representation)为理解海马—内嗅系统如何组织既往导航经验提供了一种预测性状态表征的计算视角。对于当前状态,后继表征编码在给定行为策略下未来各状态的期望折扣占据量,综合反映这些状态的可达性、预期访问频次及相对时间距离。因此,它所预测的并非下一帧感知输入或一条确定的运动轨迹,而是从当前状态出发可能到达哪些未来状态。前额叶皮层则维持当前目标和任务规则,自上而下调节海马记忆检索与前瞻性重放,并将候选未来状态与目标相关价值相结合,对不同路径或动作的长期结果进行比较,进而指导下一步行动选择。由此,状态与转移记忆、未来状态预测、目标条件化评估和行动选择构成连续的计算链条。当新环境与既有经验共享空间结构或局部转移规律时,系统可以复用已有表征,并仅对发生变化的关系和价值进行更新,从而减少从头学习整个环境的需求,为提升导航的样本效率、适应性与跨环境泛化能力提供计算基础。
认知地图的启发可以总结为3条核心机制:
感知编码与目标调控:前额叶中的感知编码将视觉感知压缩到隐空间表征供后续使用,并通过目标调控选择性注意力。
时空记忆内容与结构分离:海马–内嗅系统协同,复用空间结构、绑定记忆并预测后继表征,降低数据依赖。保留跨任务长期记忆,以惊异信号选择更新内容,减少冗余计算。
隐空间多层级预测:前额叶与海马协同,在空间范围和时间跨度上分层预测,支持陌生场景中的长程探索。
正是基于前额叶皮质-海马-内嗅皮层协同的感知编码与目标调控、时空记忆内容与结构分离、隐空间多层级预测等机制,人脑实现了低数据、高泛化的主动探索导航和价值引导操作。
具脑磐石类脑具身智能实验室(Lab for Brain-Inspired Embodied Intelligence, EBKernel Technologies Co., Ltd)的核心目标是系统性借鉴人脑结构和功能神经机制以打造逼近人脑低数据、高泛化、可终身学习、低功耗的具身智能大脑。对标人类大脑的智能实现机制,我们提出认知世界模型(Cognitive World Model,Cog-WM),目标是让具身机器人在导航、操作、交互、协作等任务的能力全面提升,快速逼近人脑水平,以支撑具身机器人更快地完成在人类的生产和生活中规模化部署应用。
本工作具脑磐石自研完成的首代类脑认知世界模型 Cog-WM 1.0,基于类脑 JEPA 隐空间预测驱动的统一架构,先后在主动探索具身导航(Navigation,Nav)和价值引导具身操作(Manipulation,Manip)上开展能力验证。其中,Cog-WM Nav 1.0 通过全局时空记忆表征与隐空间预测,实现开放环境下的主动探索与语义导航。在HM3D-Objnav Benchmark 公共评测数据集的相同子集上,相比我们复现的Nature Comms 2026 SOTA 认知地图导航方法 BSC-Nav,将导航成功率从 78.50% 提高至 86.89%,相对提升超过10%;Cog-WM Manip 1.0 通过多层级隐空间预测和价值引导的经验学习,提高操作任务的成功率与鲁棒性,在LIBERO、LIBERO-Plus、RoboTwin 2.0 Hard三个具身操作任务基准上均优于我们复现的基于海量数据预训练的SOTA操作方法 π0.5,其中Robotwin2.0 Hard子集上从37.2%提升到43.2%,相对提升超过16%。
在导航和操作任务上验证后,我们将融合两侧验证有效的机制,进一步探索长程导航操作复合任务和机器人全身一体的操控能力(Whole Body Control-based Manipulation),突破具身智能机器人的能力上限。这也正是具脑磐石打造的类脑认知世界模型基于在当前最优秀的类脑抽象概念学习框架JEPA之上开展成体系的底层类脑算法机理创新的潜力所在。
二、Cog-WM:类脑 JEPA 隐空间预测驱动的认知世界模型架构
Cog-WM 1.0 统一类脑认知世界模型架构
Cog-WM 1.0 统一类脑认知世界模型架构,将感知编码与目标调控、时空记忆、隐空间预测以及动作执行组织为一个相互联系的功能体系。我们关注的不仅是单次输入怎样生成动作,也包括历史经验怎样为当前任务提供依据、未来状态怎样参与学习与决策,以及执行结果怎样重新进入系统。
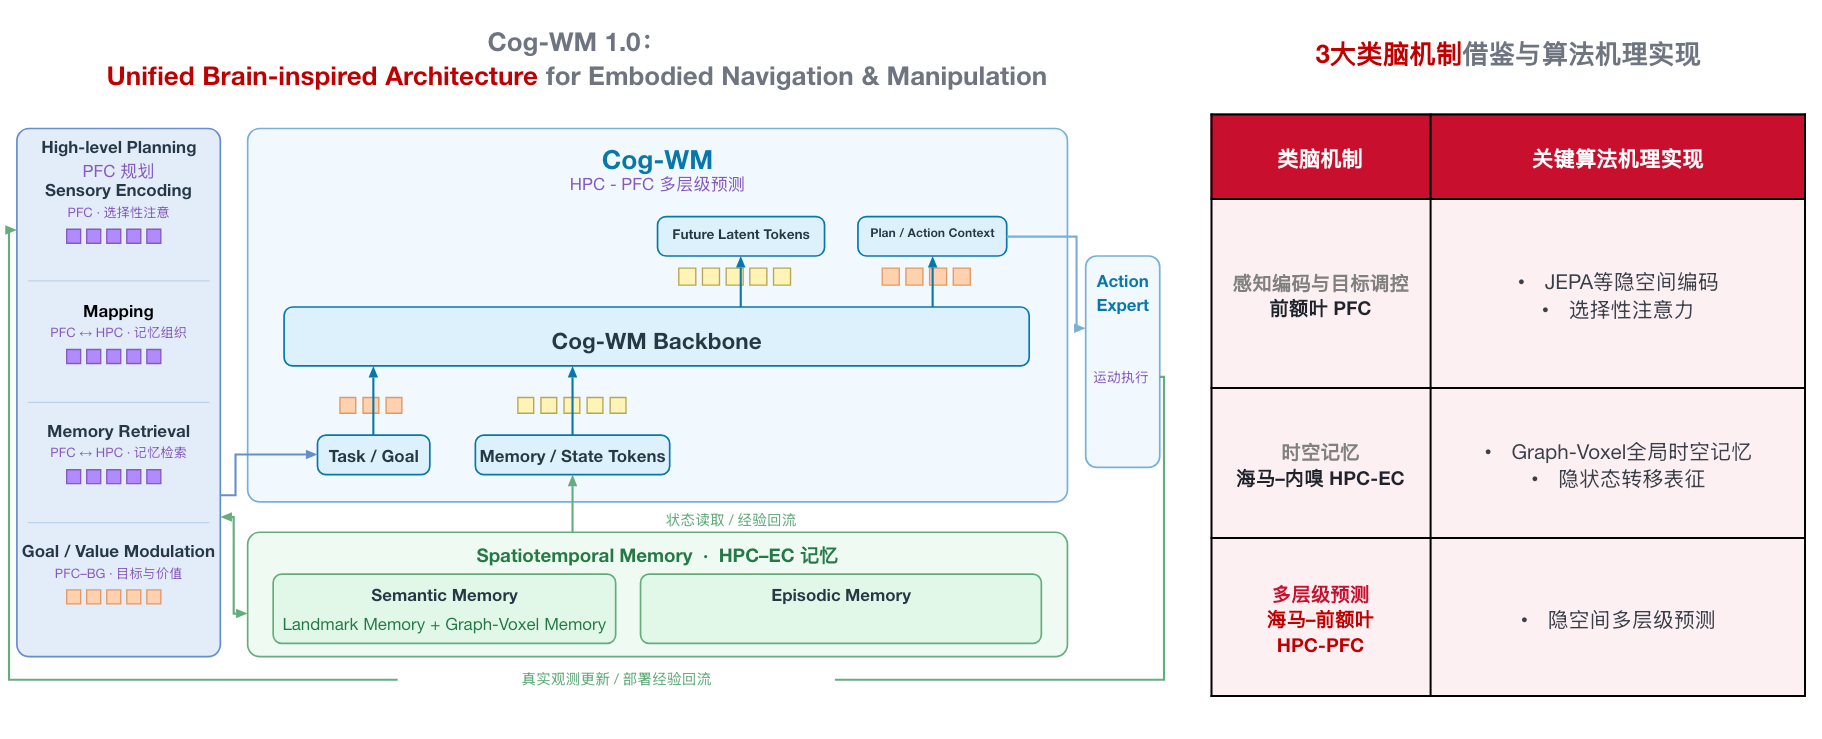
如图2所示,Cog-WM 1.0 架构借鉴了三大类脑机制。
前额叶的感知编码与目标调控机制,在高层规划模块维持任务目标,调控感知信息的选择、记忆组织与检索,实现了JEPA隐空间编码、选择性注意力。
海马–内嗅系统的结构化记忆机制,实现为稀疏的Graph-Voxel全局时空记忆模块。
海马-前额叶协同的多层级预测机制,Cog-WM 模型骨干结合目标与工作记忆,通过预测多层级未来表征和隐空间规划,再交给动作专家将这些条件转化为机器人可执行的行为,新的真实观测与部署经验再通过惊异更新反馈到相应的记忆或训练过程。
具身导航 & 操作任务的核心类脑算法改进与应用
Cog-WM Nav 1.0:基于全局时空记忆表征的主动探索与导航
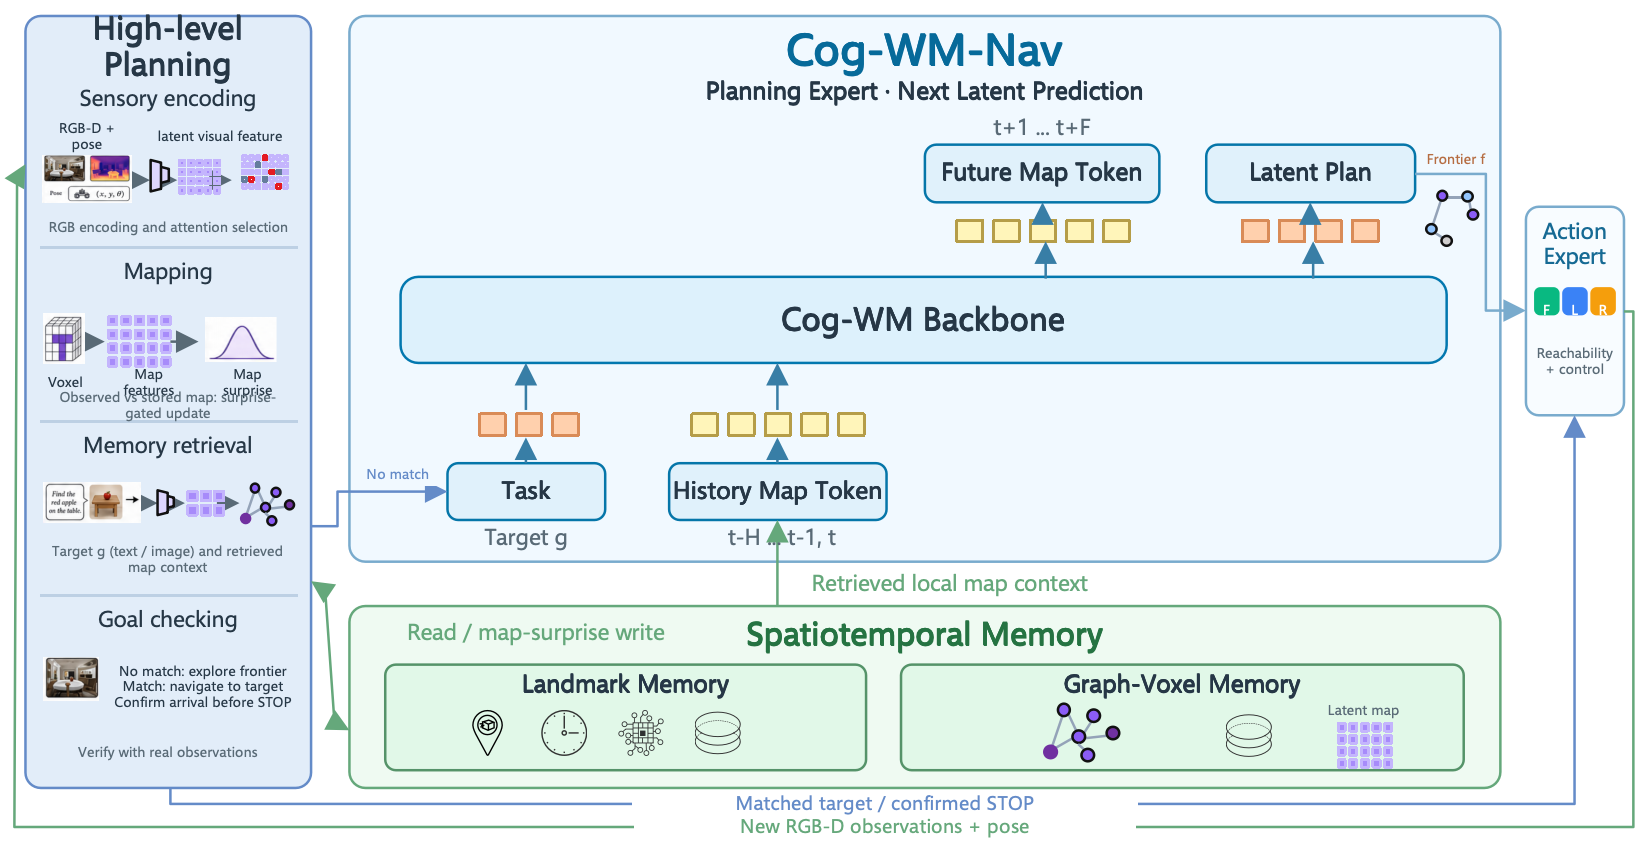
基于全局时空记忆表征的主动探索与导航架构如图3所示。
高层规划模块(High-level Planning)负责感知编码、时空记忆构建与查询、目标检查等。感知编码过程为系统提供高价值的编码特征,编码过程中首先通过模块接收机器人当前的 RGB-D 观测、位姿与运动状态,再由隐空间视觉特征编码器提取具有语义判别能力的视觉特征,并根据注意力响应和任务相关性筛选关键视觉特征,保留显著目标、小型物体和新颖区域的细粒度信息,减少背景冗余对空间记忆构建的影响,并为后续记忆更新和未来状态预测提供视觉输入。时空记忆构建将视觉编码映射到时空地图骨架中。时空记忆查询负责根据目标和当前时空记忆检索出对应的工作记忆和目标位置。目标检查则根据当前时空记忆中是否检索到目标,决定继续探索还是导航到候选目标点,并在真实观测中确认到达。
时空记忆模块(Spatiotemporal Memory)负责记忆的构建、存储、更新和检索。记忆存储过程会将筛选后的隐空间视觉特征、深度投影坐标、实例信息和机器人位姿组织为稀疏空间记忆;记忆更新时会根据新观测与已有记忆之间的惊异信号,决定新增、融合或更新相应的空间记忆单元。检索时会根据语义和语义对应隐空间视觉特征从Landmark memory和Graph-Voxel memory中匹配到最相似的候选导航位置。
Cog-WM Nav 模型接收当前隐空间视觉地图特征、导航目标,预测未来多尺度隐空间视觉地图表征和计划导航点位置。模型基于JEPA隐空间训练的学习范式,在隐空间视觉地图特征上进行预测,使学习目标集中于对导航决策有用的状态变化。
推理:基于Cog-WM Nav 1.0执行语义导航任务的详细流程如下,系统首先环视四周并构建当前位置的隐空间视觉地图特征。然后根据文本或图像目标从Landmark memory和Graph-Voxel memory中检索相关区域。如果存在目标,则直接导航过去;如果不存在目标,则通过Cog-WM预测未来并高效决策探索位置,并对环境进行探索,探索过程中会根据惊异程度更新时空记忆,并在探索后进行检索;重复探索-检索过程,直到检索到目标并确认到达,由此形成“感知、记忆、预测、行动、惊异更新”的完整闭环。
训练:Cog-WM Nav 1.0整体模型参数~1B,训练数据采集自 HM3D 仿真环境,约12K条 15.4 小时训练数据。
Cog-WM Manip 1.0:基于隐空间预测和价值引导学习的操作
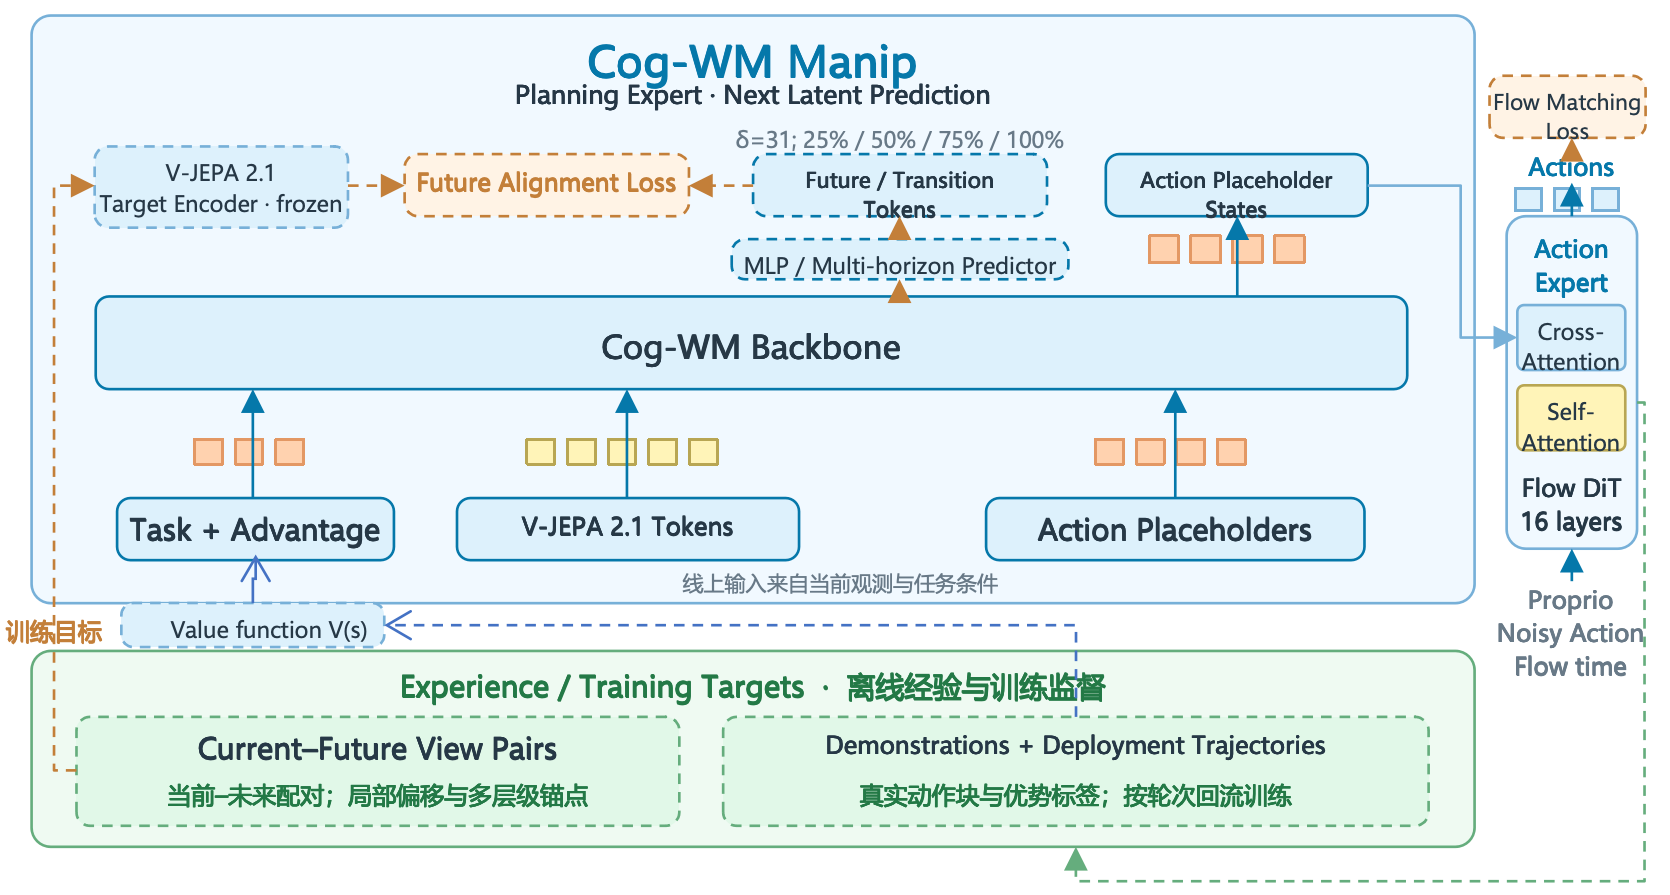
在导航能力验证的基础上,我们将共享机制在具身操作任务上实现,形成 Cog-WM Manip 1.0,其架构图如图4所示。
Cog-WM Manip 模型实现了隐空间多层级预测机制,局部后果与轨迹进展共同监督表征学习。模型采用 V-JEPA 2.1 编码视觉输入,以当前–未来观测配对构建预测学习目标。局部预测采用固定偏移,关注较近时间范围内的状态变化;多个更长跨度的目标则补充轨迹进展信息,使表征学习兼顾局部动作后果和更远的任务过程,以目标为导向,避免仅以动作模仿作为唯一学习目标。
价值引导的经验学习模块则利用了成功与失败轨迹。部署过程中产生的轨迹质量并不相同。一段没有完成最终任务的轨迹,仍可能包含有效的物体运动、接触后果或恢复过程;但其中的动作也不能不加区分地作为示范重复模仿。因此,Cog-WM Manip 1.0 将状态变化的学习与行为质量的评估分开组织:有效轨迹用于学习后果,价值函数与片段优势用于指导策略怎样利用这些经验。系统通过价值评估得到动作片段的优势信号,并赋予正向或负向的行为条件;训练时也使用不附加行为质量标签的空条件,结合任务文本开展策略学习。示范轨迹与部署轨迹按轮次汇集、标注和训练,改进后的策略再进入下一轮执行,由此形成经验回流过程。
推理:在线执行时,模型依据当前观测、任务条件与本体状态生成动作,无需显式预测未来,降低计算量。
训练:Cog-WM Manip 1.0整体模型参数~ 1.3B。训练数据来自各个Benchmark官方训练数据及离线处理好的价值引导数据。
三、对照实验
Cog-WM Nav 1.0:类脑时空记忆 & 隐空间多层级预测机制显著提升开放环境主动探索和语义导航成功率
HM3D-ObjectNav 实验结果
为了验证 Cog-WM Nav 1.0 的语义导航能力,我们首先在仿真环境中对其进行了能力评测。本研究在 HM3D Object-Goal Navigation benchmark上进行评估。HM3D-ObjectNav 是由 Meta AI Habitat 生态推动、在国际具身智能研究中广泛采用的权威对象导航评测,是衡量具身智能体能否在未知室内环境中完成对象导航任务的核心标准之一。HM3D ObjectNav v2 基于 HM3D-Semantics v0.2 构建,共包含216个具有语义标注的真实室内三维重建场景,按照145个训练场景、36个验证场景和35个测试场景进行划分。场景涵盖住宅、办公室及多房间室内空间,目标类别包括椅子、沙发、盆栽、床、马桶和电视等6类常见室内物体。数据集中的每个 Episode 均包含独立的场景、机器人初始位置与朝向、目标物体类别及对应目标实例;所有任务均可在同一楼层内完成,无需跨楼层导航。评测时,智能体从随机位置和朝向出发,在不使用预先提供的环境地图和目标坐标的条件下,根据RGB-D观测完成环境探索、目标检索和路径规划。当智能体在满足评测协议规定的目标到达条件下执行 STOP 动作时,判定该 Episode 导航成功;具体距离和有效目标视点条件遵循本次复现实验采用的任务配置。
为了更好地复现和对标前人研究的结果,也为了更快捷地对我们类脑算法创新的能力增益开展对比评估,本研究选取 HM3D benchmark 中 50% 的评测数据进行复现实验。首先在相同数据划分和评测协议下复现 BSC-Nav 作为基准方法。其中 BSC-Nav 是发表于 Nature Communications 2026的国际领先、具有标杆意义的类脑空间认知与结构化空间记忆导航方法,报告了 HM3D-ObjectNav 上的领先结果。然后在同一批评测 episode 上运行 Cog-WM Nav 1.0,以保证两种方法的比较建立在一致的场景分布、目标类别和任务难度上。由于本节实验采用的是 50% HM3D 子集复现设置,因此本文暂不与其它使用全量 HM3D 或不同 HM3D 版本、不同输入模态、不同评测协议的方法进行直接数值比较,而重点分析 Cog-WM Nav 1.0 相对于 BSC-Nav 的改进效果。
评估指标采用 Success Rate(SR)和 Success weighted by Path Length(SPL)。SR 表示导航任务成功率,即智能体在规定步数内到达目标附近并正确执行停止动作的 episode 占比,主要衡量方法是否能够可靠找到目标。SPL 在成功率基础上进一步考虑路径效率,若智能体虽然成功到达目标但路径明显绕远,则 SPL 会降低,因此该指标同时反映导航成功性和路径规划效率。
一般而言,SR 更关注目标定位与探索能力,SPL 更关注路径选择和执行效率。实验结果评测如下:
| Method | HM3D SR | HM3D SPL |
|---|---|---|
| BSC-Nav | 78.5 | 47.7 |
| Cog-WM Nav 1.0 / Ours | 86.89 | 48.35 |
| 相对提升 | 10.69%↑ | 1.36%↑ |
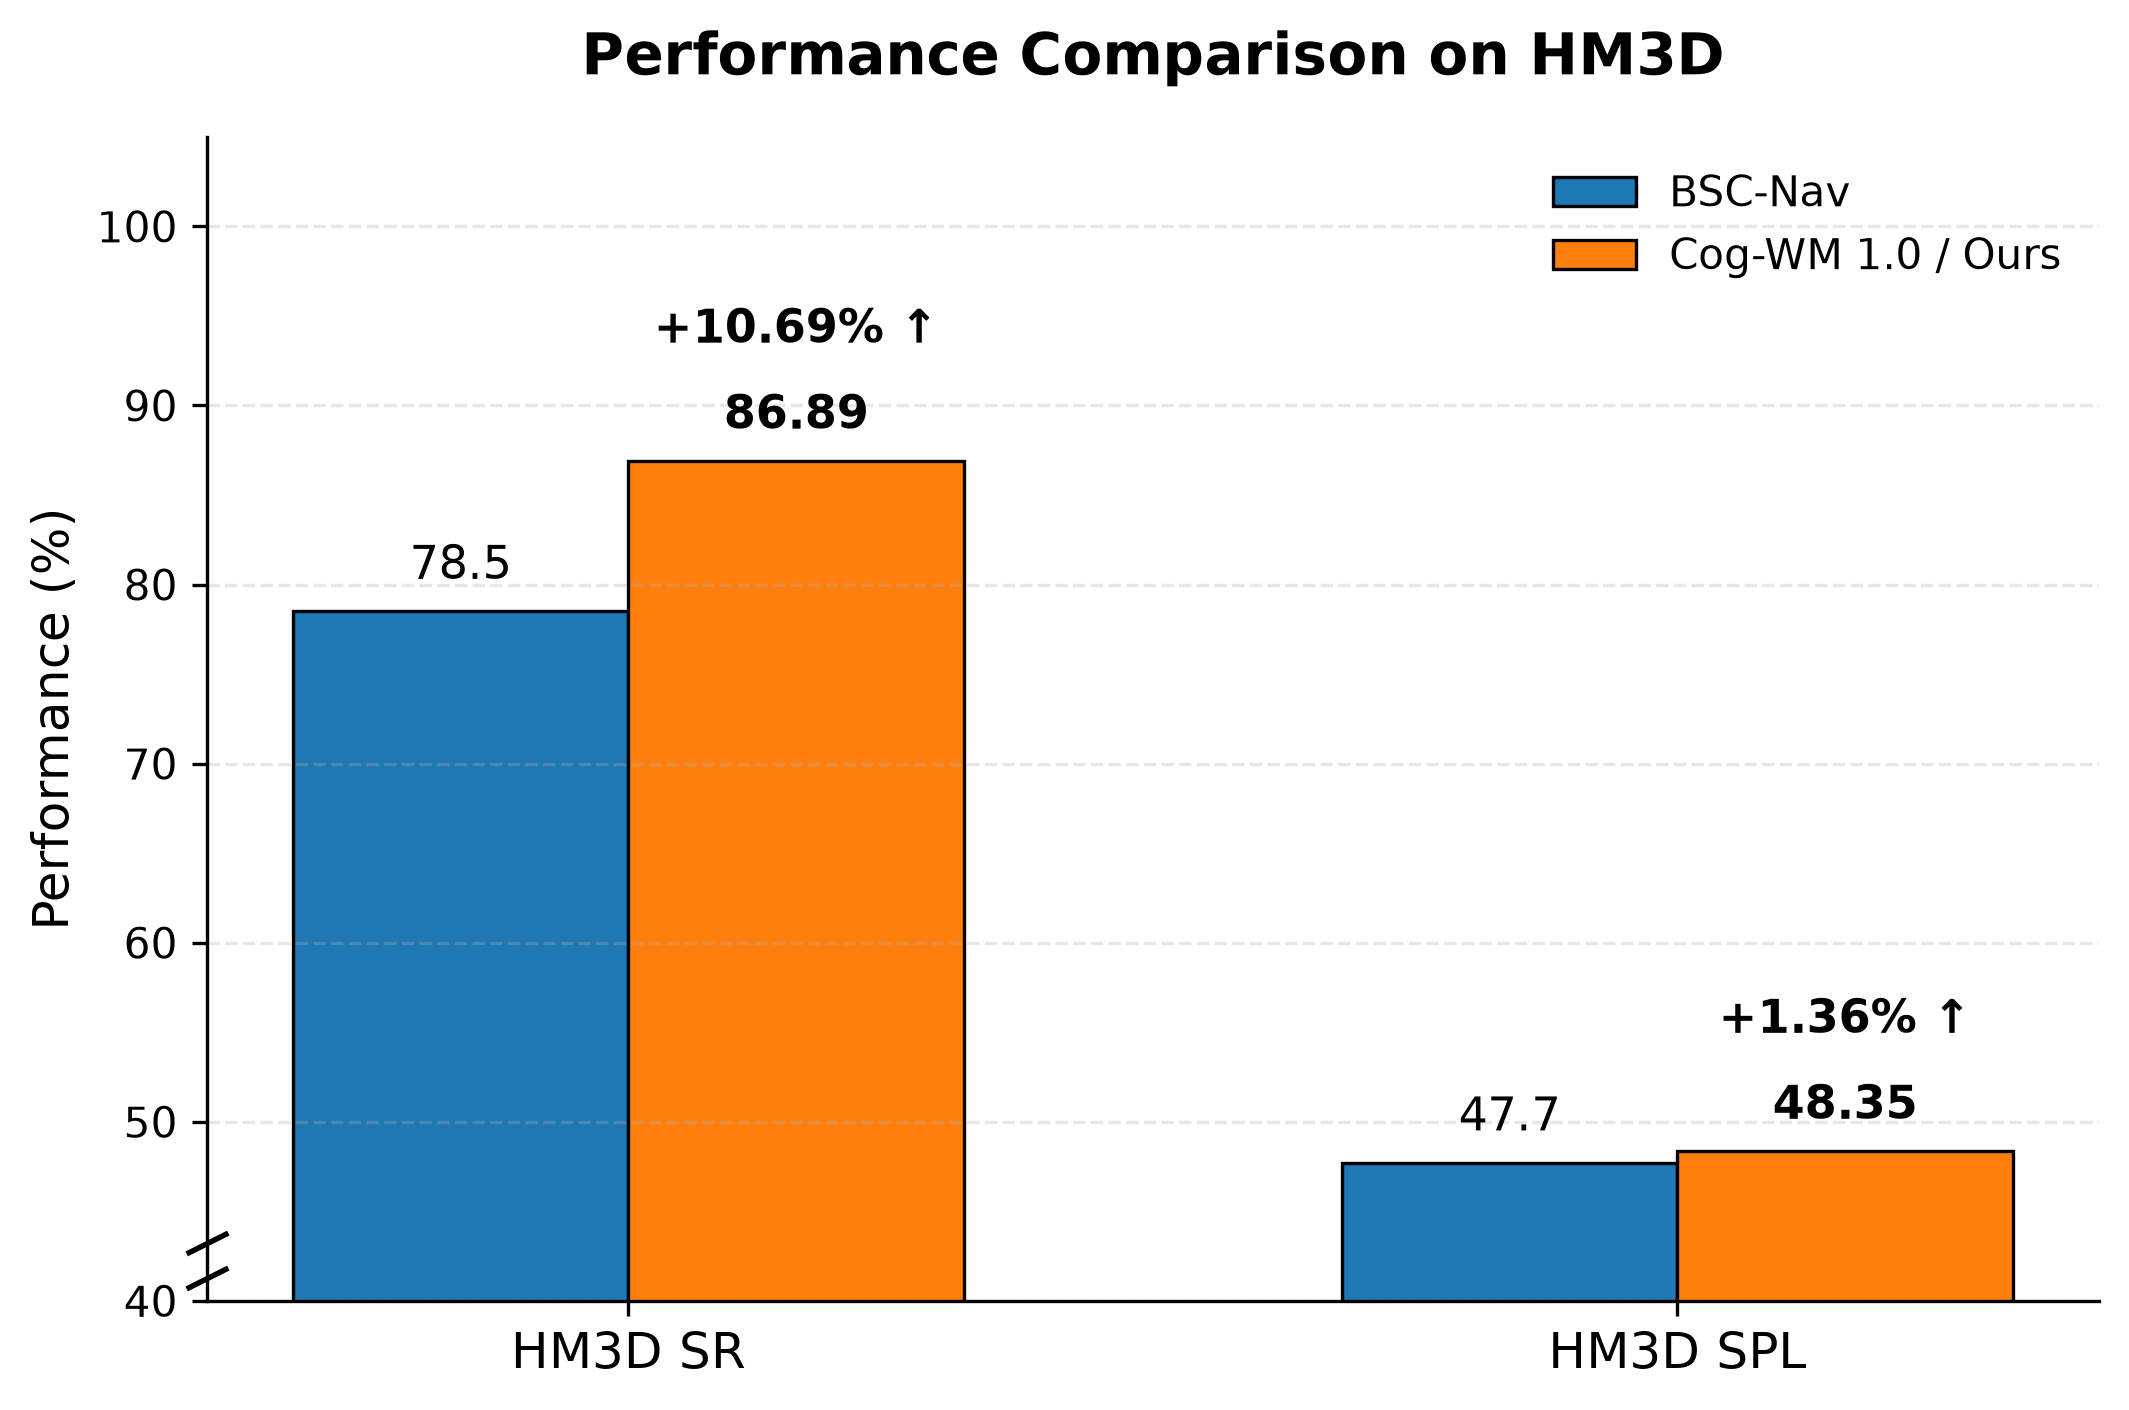
实验结果表明,在相同 50% HM3D 评测子集上,Cog-WM Nav 1.0 的 SR 达到 86.89%,SPL为48.35%,相较复现的 BSC-Nav(SR 78.50%、SPL 47.70%),分别增加 8.39 和 0.65 个百分点,相对提升 10.69% 和 1.36%。这说明 Cog-WM Nav 1.0 在这组评测中具有更高的任务完成率,能够在更多 Episode 中成功找到目标。
仿真环境结果讨论
总体来看,该 Benchmark 的对比结果说明 Cog-WM Nav 1.0 在保持与 BSC-Nav 接近路径效率的同时,显著提高了导航成功率。
对于具身导航任务而言,这种提升具有非常高的产业应用价值:在真实机器人或长程导航场景中,导航失败往往比路径略长带来更高代价,因此 SR 的显著提升意味着系统具有更强的可靠性和任务完成能力;同时 SPL 没有下降,在本组评测中体现出更好的整体任务表现。其对真实场景部署成本和长期可靠性的影响,还需要在持续运行中进一步测量。
如下为对比视频样例,仿真环境对比视频 BSC-Nav(左)vs Cog-WM Nav 1.0 (右)
该场景中,目标受到家具、墙体和视角遮挡,机器人在初始位置无法获得完整的目标视觉特征。BSC-Nav主要依赖当前已写入地图的显式语义特征进行检索;当目标尚未被观测到时,容易在局部区域反复搜索,因而左侧轨迹呈现出更长的绕行和重复探索。Cog-WM Nav 1.0则结合空间记忆及未来隐空间预测,优先移动到预期能够揭示新空间语义、并可能提升目标可见性的区域。右侧Cog-WM Nav 1.0的运动轨迹显示比左侧的BSC-Nav更早进入目标所在区域,并更早完成目标发现和停止;此后画面不再运动,反映的是任务已成功完成。
真实环境下的部署评测
为了验证 Cog-WM Nav 1.0 的主动探索与导航泛化到真实物理空间的能力,我们在以上仿真实验之外,在具脑磐石研发区开展了真实环境下的主动探索与导航能力验证,并同时评测了有关时空记忆检索与空间目标问答的真机部署测试。
我们通过将本体无关的 Cog-WM Nav 1.0 与本体强相关的低层运动控制模块解耦,为后续适配四足机器人、双足机器人、移动机器人等多构型平台提供接口基础;不同本体上的实际效果仍需分别验证。本次评测中我们选择将 Cog-WM Nav 1.0 部署在 Astribot S1 轮式双臂人形机器人平台上。该机器人配备了NVIDIA Jetson AGX Orin 计算平台、RGB-D 相机、激光雷达(LiDAR)以及多种本体传感器,为实时环境感知、时空地图构建以及导航推理提供了充足的计算能力。
本实验展示了机器人在未知室内环境中通过类人认知地图构建机制在线实现开放环境下的主动探索与语义导航能力。在没有任何预先构建2D或3D地图、也未提供目标具体位置的情况下,机器人能够在开放的物理世界里主动探索环境,同时持续构建基于时空记忆的认知地图。
结果表明,装载Cog-WM Nav 1.0大脑的机器人随着在开放环境下的自由探索过程的开展,新观测到的语义目标会与对应的导航节点建立关联,并存储到时空记忆中,从而不断积累环境的空间知识。
如视频所示,左侧显示机器人在导航过程中构建的认知地图,其中绿色圆点表示历史导航节点,节点之间的连线表示相邻节点之间可通行的连接关系,高亮标记表示机器人当前所在节点。右侧展示头部 RGB-D 相机的实时感知结果,视觉感知编码模块对环境中的语义目标进行检测。
综上可见, Cog-WM Nav 1.0 在算法机理上能够驱使具身机器人在未知环境中同时完成机器人主动探索下的时空记忆表征构建以及目标自主规划导航,而无需依赖预建地图,并为减少场景部署工作提供了可能。具有服务于开放世界环境下的家庭服务机器人部署的价值与潜力。
本实验展示了 Cog-WM Nav 1.0 的空间推理能力和时空记忆与检索能力。
如视频中间字幕所示,首先向机器人提出问题:“植物旁边有什么?” Cog-WM Nav 1.0 通过检索时空记忆中的语义记忆信息,正确回答植物旁边放置着一个黑色垃圾桶。这一结果表明,具脑磐石构建的时空记忆不仅保存了目标物体的位置信息,还记录了周围物体之间的空间关系信息,从而支持 Cog-WM Nav 1.0 具备时空记忆检索及空间目标问答的能力。
接着向机器人发出指令,要求寻找之前很早阶段观察过的物品(某植物)。此时,机器人并非仅依赖当前视野内观察到的视觉信息,而是通过 Cog-WM Nav 1.0 从时空记忆中检索目标的历史位置,进而实时规划导航机器人移动路径直至找到目标所在具体位置。
总体而言,本工作的真实物理环境下的真机实验在仿真环境之外有效展示了 Cog-WM Nav 1.0 能够实现在未知环境的自由探索、认知地图实时构建、时空记忆与检索以及空间目标问答等能力。 基于Cog-WM Nav 1.0的类人认知导航系统可通过持续将语义观测与空间位置进行关联,让机器人能够有效复用探索过程中积累的环境知识,从而支持长距离导航和空间推理任务。
Cog-WM Manip 1.0:类脑 JEPA 隐空间多层级预测 & 价值引导机制叠加显著提升操作任务成功率
仿真环境实验结果
为了验证隐空间多层级预测与价值引导学习的作用,我们在 LIBERO、LIBERO-Plus 和 RoboTwin 2.0 三个仿真操作基准上进行评测。LIBERO 关注空间关系、物体、目标与较长任务过程,LIBERO-Plus 进一步考察相机视角、光照、背景等变化下的表现,RoboTwin 2.0 则提供双臂操作及多种场景随机化条件。这些评测共同覆盖了任务完成能力以及环境变化下的操作鲁棒性。
各基线使用相同的示范、观测视角、动作归一化、任务清单和评测预算进行复现。以下结果为 3 个随机种子的均值与标准差,单位为成功率百分比;比较对象是本次统一协议下的复现配置。
| Benchmark | JEPA-WAM | π0.5 (SOTA) | Ours | VS SOTA 相对提升 |
|---|---|---|---|---|
| LIBERO | 96.7 | 96.9 | 98.2 ± 0.4 | +1.3 |
| LIBERO-Plus | 79.2 | 84.5 | 84.6 ± 0.7 | ~ |
| RoboTwin 2.0 Hard - 20task | 36.9 | 37.2 | 43.2 ± 1.3 | +16.2 |
实验结果表明,在上述统一复现协议下,Cog-WM Manip 1.0 通过类脑 JEPA 隐空间多层级预测 & 价值引导机制叠加,在三个操作基准上均取得更高的平均成功率。
多层级预测与价值引导的消融实验
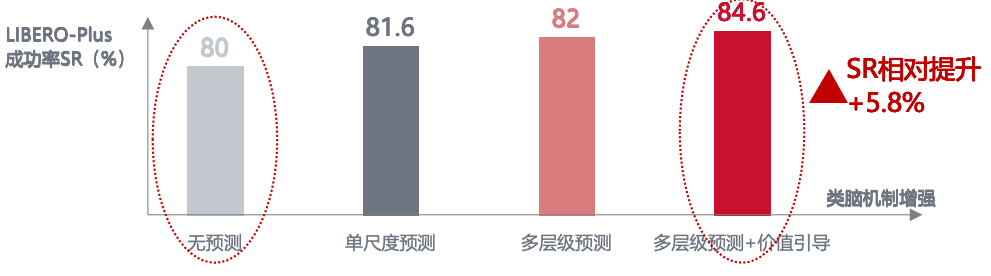
为进一步区分不同机制的作用,我们在相同训练设置下比较无未来预测、仅有单尺度预测、加入多层级预测,以及进一步加入价值引导的配置。在 LIBERO-Plus 上,单尺度预测使成功率从 80% 提高到 81.6%,加入多层级预测后达到 82%,进一步结合价值引导后达到 84.6%。完整配置比无预测配置相对提升约 5.8%。说明两种机制的有效性。
视觉环境扰动下的操作对比
该样例展示在视觉环境变化下执行同一操作任务的过程,Cog-WM Manip 1.0 相比于Baseline显著提升多种视觉噪声环境下的操作任务鲁棒性。
四、总结与讨论
综上表明,由具脑磐石类脑具身智能实验室(Lab for Brain-Inspired Embodied Intelligence, EBKernel Technologies Co., Ltd)研发的首代认知世界模型 Cog-WM 1.0,通过系统借鉴人脑感知编码与目标调控、时空记忆内容与结构分离、隐空间多层级预测等机制,以类脑 JEPA 隐空间预测驱动的统一架构,先后验证了主动探索具身导航和价值引导具身操作的能力。导航侧显著提升在无预置3D地图条件下、基于时空记忆的更高效主动探索与导航能力;操作侧显著提升多种视觉噪声环境下的操作任务鲁棒性。总体来说验证了面向家庭与商服的开箱即用 ,降低训练和部署成本。
鉴于本次研究主要目的是为了快速验证我们算法机制改进的有效性,我们采用了小参数模型和配套的小规模数据集开展实验研究。展望未来,具脑磐石将把已经在导航与操作上分别验证的机制推进到融合训练与长程复合任务中,并进一步进行数据样本多样性增强、模型参数提升:让机器人既能利用全局时空记忆找到目标,也能结合物体状态与行动后果完成操作,并逐步扩展到机器人全身一体的操控能力(Whole Body Control-based Manipulation),进一步突破导航与操作复合的具身智能机器人能力上限。这也正是具脑磐石打造的类脑认知世界模型基于当前最优秀的类脑抽象概念学习框架JEPA之上开展成体系的底层类脑算法机理创新的潜力所在。
从更长期的研发路线看,我们将围绕“建模世界、建模计算、建模自我与他人”持续推进。建模世界是在当前已起步的导航与操作结果上,逐步支持更长的复合任务;建模计算通过分层稀疏与惊异驱动的自适应认知计算,实现低功耗;建模自我与他人则进一步探索元认知、内在动机与心智模型,为交互、协作和终身学习提供基础。我们将遵循“沿途下蛋”的商业策略,把验证成熟的能力逐步转化为客户可感知的产品与解决方案,并通过真实场景反馈持续推动模型研发。
类脑智能是全球AI创新领域的国际最前沿。具脑磐石类脑具身智能实验室(Lab for Brain-Inspired Embodied Intelligence, EBKernel Technologies Co., Ltd)协同自身努力与全国范围内的脑与类脑智能科学家们深耕类脑智能AI算法创新,致力于为我国在全球AI根技术创新、构建全球 AI 技术第二极的生态版图构建中抢占战略制高点。在开展根技术创新的同时,具脑磐石也将面向具身智能机器人的产业应用通过扎实的研发逐步为全行业提供类人认知水平的具身导航、操作、交互、协作能力服务。